刷屏的 Jev 是啥?12 个真实场景看懂“系统一”AI
最近 AI 圈刷屏的 Jev,画风有点奇怪。
别的模型都在比谁更能写:写代码、写报告、写情书。而它,一个字都不生成。你问它“今天天气怎么样”,它不会回答你——它只输出三样东西:选哪个、打几分、是不是。
听起来像个废物?恰恰相反。这个由前 OpenAI 研究员 Diogo Almeida 创办的 TypeSafe AI 推出的“系统一”模型,正在悄悄进入普通人的家里、手机里、浏览器里——不是以聊天机器人的方式,而是以你完全察觉不到的方式。
心理学家把人的思维分成两套系统:系统一是快直觉——你看到红灯立马踩刹车,不需要“想”;系统二是慢思辨——你写年终总结,得一个字一个字憋。
ChatGPT 这类大模型是标准的“系统二”:什么都能想明白,但每次都要“组织语言”,慢、贵,还必须有人坐在对面看。而生活里 99% 的判断,其实只需要系统一:门铃响的是不是快递?这封邮件急不急?这个按钮该不该点?——需要语义理解,但不需要写一段话。
Jev 干的就是这个:把这类决策从昂贵的大模型调用里剥离出来,用极低的成本和延迟完成。一张图看懂两者的区别:
回头看这 12 个场景,你会发现一个规律:Jev 在普通人生活里扮演的从来不是“助手”,而是过滤器、分拣员和触发器。它不跟你对话,不邀功,不刷存在感——它只在你使用工具的间隙,默默完成一次又一次毫秒级的判断。
这可能是 AI 走向成熟的标志:第一阶段的 AI 要你迁就它(学提示词、开对话窗口),第二阶段的 AI 藏进工具里迁就你。判断模型没有存在感,恰恰是它最大的存在感。
免责:Jev 为 TypeSafe AI 产品,功能与定价以官方页面为准 · 本文不构成任何投资建议
网站被人攻击
我的漫剧创作网站被人攻击,攻击来源地址 89.185.27.170,是一个香港的服务器,可能是租的临时服务器。今天我并没有做什么特殊的操作,但是,有可能是在抖音评论了,然后被人盯上,然后顺藤摸瓜找到了我的漫剧网站,就开始去挖我的漏洞。DDos攻击没有用,因为我有防护,结果他就开始给我做登录请求轰炸,拼命的请求验证码。虽然他反复请求实际不会得到更多验证码,因为我有代码逻辑。但是,架不住他反复请求,导致我服务器被塞满,我自己都进不去了。最后,它搞得我请求限额,直接被cf拦截。我看了数据,从8点后开始弄,我10点才发现。
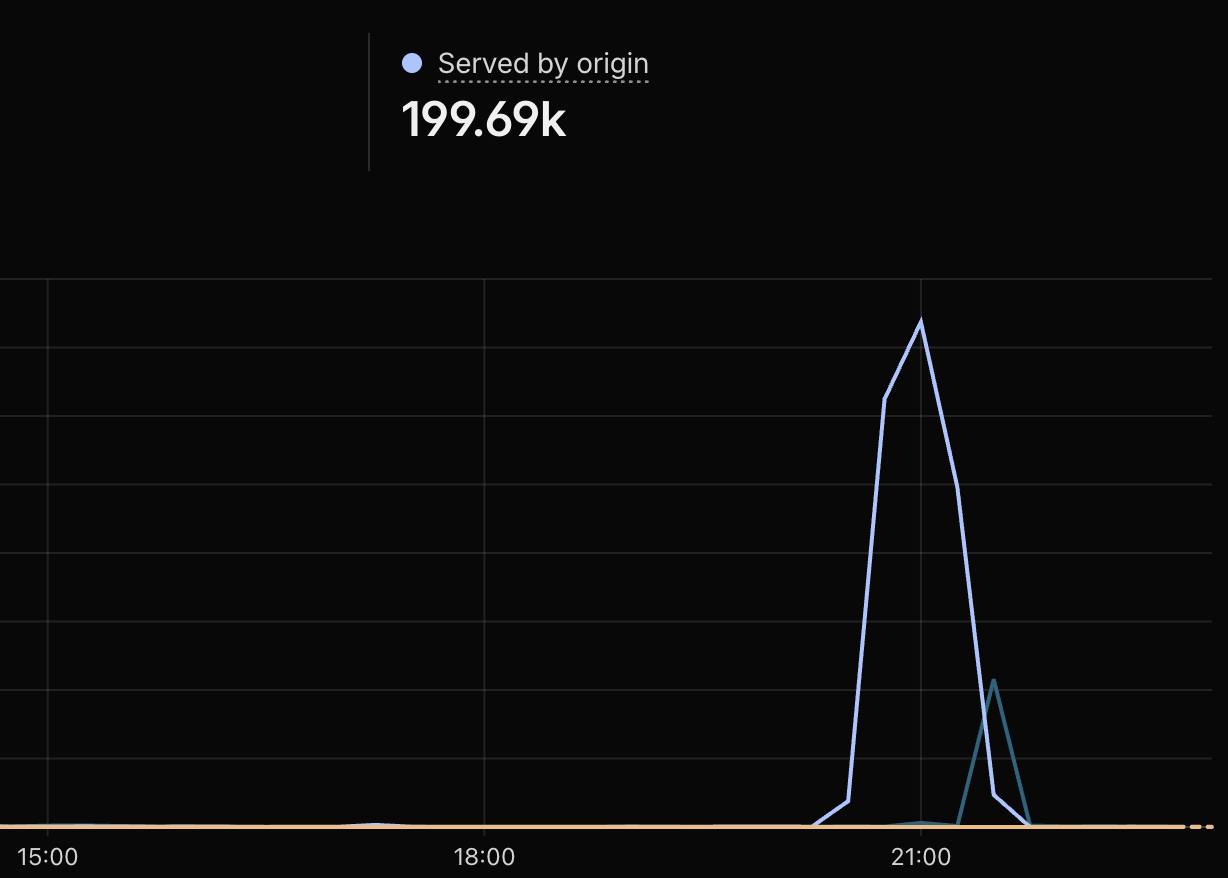
我随机发起了反击,对它的服务器进行轰炸,我看它服务器也慢慢响应变慢。cf真的是好用,我赶紧做了防护,后面它的请求根本就来不了我这里,让它慢慢瞎折腾吧,以为自己厉害,实则垃圾一坨。
这件事也警醒我自己,做人做事,要夹着尾巴,有的时候,一时兴起,去做评价,去触碰到别人的利益,就很可能遭到报复,毕竟现在的坏人比较多。想要做事,就要耐得住寂寞,能憋住不说话,能在看到一些不合理时,善于等待,在遇到自己擅长的事情时,善于收起尾巴。这不是说人要圆滑,而是保护自己的一种方式。
这次的教训,我会记住。
glm-5.3-flash 背刺 deepseek-v4-flash
昨晚看到消息,glm-5.3-flash正式发布,随即我就去官网查看,这次智谱是真给东西,首先是价格,¥0.8/inputMTokens,¥2.8/outputMTokens,这个价格就非常香了,因为之前在openrouter上以Ox Alpha的名称跑了一个星期,大家的反馈都说太香了,这个价格,和他家的其他模型比起来,真的是非常便宜。其次是多么态,这个真的是千呼万唤始出来,它支持对图片、视频的理解,实在是太赞了,不过这里也要考虑到输入token的增量,价格和多模态相互作用,但是无论如何,统一多模态模型终于上了。再来,并发率,这次慷慨的给到50,比以前抠抠馊馊好太多了,这意味着可以在生产环境上去使用。最后,速度,作为flash模型,速度杠杠的,当然,作为flash模型,它的能力必然比正式模型弱一些,但是从社区在openrouter上的反应来看,也可以和opus掰掰手腕啦。
相比而言,deepseek经过上一轮涨价之后,优势全无,除了并发比较慷慨之之外,其他全都比不上了。哎,我本来很喜欢deepseek的,慢慢也有点无感了。
到底谁会用DeepSeek Harness?
到底谁会用DeepSeek Harness?这可能是他们团队自己没有想清楚的问题。不可否认,自进化的可插拔式特征,符合了Agent本身的发展趋势,但是,就现阶段而言,如果我们沉下心,我们就会问出这样一个问题:“DSH的用户到底是谁?”
为什么会有这样的问题?因为,从DSH的整体设计来看,使用它的人,是这样的一个画像:追求Agent的自我进化,不需要稳定的业务场景,不需要Agent有固定的执行模式,在开发或工作中接受随时变化的Agent Loop和Harness,花比较多的时间寻找插件,有时候甚至自己上手写一个插件。
而它的对立面是这样的一群人:追求在业务场景中有稳定的工作流和稳定的输出。
这就是我发出这个疑问的本质根源。
虽然我们热爱技术,对充满挑战的未来抱有期待。但同时,我自己作为一名创业者,我非常看重,起码在短期内,Agent Harness应该解决用户什么问题?本质上,我们需要提出一个问题就是:如果使用DeepSeek Harness构造出新的类Claude Code这种vibe coding产品,有多少用户会为此埋单?因为从DSH的定位来看,他们不会官方推出类似的vibe coding产品,他们会解释道:DSH是一个包罗万象的框架,你可以自己用社区的插件,构造出和ClaudeCode一模一样的coding agent出来。同样的话,适用于workbuddy、codex等桌面端agent应用。也就是说,DSH不为最终的终端agent用户负责,而是为能够基于DSH搭建起这类agent的用户负责,虽然这两类用户有部分是重叠的。
那么,基于DSH构建的coding agent,和ClaudeCode类固化coding agent,本质区别在哪里?我认为主要有两点:1)ClaudeCode有专业团队维护,无论是功能性bug,还是安全性漏洞,都有负责团队追踪解决;2)ClaudeCode内置了针对编程的固定模式范式,也就是垂直行业标准工作流,能够通过长期在该垂直领域(编程领域)积累经验,将更加优秀的模式范式,沉淀到工具中甚至模型侧。这两点,DSH无法具备,而基于DSH构建的agent,由于持续更新插件,也无法做到稳定。这就会造成非常尴尬的局面。我在过往的历史中,遇到过相同境遇的项目,就是react-native,也是非常好的想法和理念,但是也是只管内核,能力全靠社区,而与它对应的就是flutter,一个框架全包,最后的结局大家也都看到了,现在react-native这个项目,基本上处于死亡边缘。
相比较而言,Pi这个框架则更稳定一些,虽然它本身所给的用户画像,和DSH几乎一样,但是,在稳定的业务流程构建上,却比较保守,可以作为稳定的生产环境底层框架。
最后,我得到的结论是,Pi更适合作为业务系统的Agent底层框架,而DSH更适合用于构建类似钢铁侠电影里面的“贾维斯”这样的超级人工智能系统。
DeepSeek Harness目前还是技术驱动,距离产品可用还有一段距离
因为靠这DeepSeek这个牌子,DSH一发布就获得了巨大流量。我在收到消息的第一时间,就去了解,第一反应是:这玩意和Pi有什么区别?在深入理解之后,发现确实还是有本质的区别。Pi更收敛,其哲学是做减法,不要搞一堆有的没的,把功能都掌握在开发者自己手里。而DSH其实完全相反,其哲学是直接交出自主权,去做DNA,除了底层代码不变,所有的模块都可以变,都插件化。所以,用DSH构建的应用,更具有科技感,它可以自己进化,随着社区的发展,可以获得更强功能。

但是,我想说的是,我比较喜欢从泼冷水的角度,去冷静、消极一点的分析。DSH本身没有新东西,它只是背靠DS这棵大树,获得了较大流量而已。他们团队发了一篇类似论文的东西,我感觉就是为了牵强附会,没有理论价值。当然,它在工程上的探索,对于我们开发者而言,工程师们的G点被触发了,大家看到这种工程上的尝试,就像磕了药一样的,非常开心和热闹。这对开发者而言是一场狂欢,因为大家可以在一种曾经设想过但是没有实际实践过的项目下,去追求自己在技术上的畅想。但是,就目前而言,DSH在产品上仍然是零,甚至是负数,它给DeepSeek带来了巨大隐患,因为对于群众的预期而言,绝大部分DS的信徒,都是在期待一款可比肩Claude Code 或 Codex 的桌面级Agent,但是现在DSH出来的,本质上是一个类似React或者Spring之类的编程框架,然后在产品层面,更像是为了验证这套框架的可行性而给出了一个Demo一样。最后,大家会不会为此埋单,以及类似TraeWork、WorkBuddy之类的团队成员,在看到这种所谓“自进化Agent”的理念后,会不会在自家Agent中去践行,还是嗤之以鼻,都是未知数,因为对于这些已经相对成熟的Agent产品而言,已经有了成熟的商业模式,技术上,使用最稳妥的方案,来驱动自家产品,比使用一套更能激发技术G点的方案,可能前者更有商业价值。
当然,这不代表着我对DSH持否定态度。任何刚出来的技术,总会沉寂一段时间,然后在另外一个产品上得到爆发,例如Pi本身很安静,但是却催生了openclaw这样的产品一样。
真开源!Kimi K3这次真的掀桌子
昨晚,Kimi终于把K3开源承诺兑现了。之前传出的消息是,会完全开源权重,也就是可以部署到自己的服务上,但是今天看到的结果是,不仅开源了完整权重,而且连推理内核、MoE 通信库、Agent 训练环境整套底层技术栈全部都开源了。采用了MIT协议和商业授权双层协议,可以说是AI开源最完美的一次呈现。
对企业来说,特别是中国企业,只要拿到Kimi官方授权,就可以上架自己的K3服务,阿里、字节这些,很快就能上。可以想象,这里的授权费不会高的离谱,毕竟是国内企业。而对于想要进入大模型这一行的普通开发者而言,则是盛宴级别的资源,特别是对国外的开发者,是绝对的冲击。
国外的那些工程师,都很聪明,他们趴下来看了以后,去改进改进,很快就会发布自己的大模型(自研),就像之前Cursor的操作一样。这对国外的那些闭源模型是一次掀桌子的打击,他们怎么也想不到,一个中国模型,还开源,怎么就把自己干翻了。这样的场景,在2025年初我们就见过一次,当时,deepseek r1发布,也是开源,直接干翻当时刚发布没多久的o1模型,引起了一阵恐慌。
当然,这次开源对我们普通使用者来说,实际的好处不是非常大,但是也有非常积极的作用。由于K3的参数量摆在那里,算力成本高,即使第三方的服务,价格必然也比之前模型更高。但好处很明显,就是我们有更多的选择,不一定非得接官方的API或plan,说实话,这段时间我用官方的kimi code接K3,消耗非常快。但如果像字节、阿里它们上线,整合在自己的coding plan里面,那么就可以分摊成本,我们用户端也可以有更低的成本来使用。
这次对Kimi的看法,真正得到了改观。从deepseek到kimi,这两家大模型真的是撑起了中国大模型创新的旗帜,说不定后面还会有更多。
FLUX 3
FLUX 3 出来了,又是一个王炸级别的模型,黑森林这个实验室是真的极客风格,从 flux kontext 封神到被超越,中间无声无息这么久,没有做营销,只专心做研究。FLUX 3 是一个真正的多模态输入多模态输出的模型,他们没有公布具体采用了哪个LLM底座,但是估计仍然是Qwen系列。目前来说,这样的多模态模型,独此一份,其他比如gpt、gemini都是agent实现。
卸压小游戏
在群里看到有个小伙伴发了一个开源的小游戏,感觉非常解压,就fork过来,做了一些调整和优化,让交互起来更有意思。
https://game.tangshuang.net/wangwang
上班的时候,或者无聊的时候,可以打开来遛一下,还是非常解压的。
Kimi K3 把我当日本人整
听说Kimi K3已经把claude和gpt都给干怕了,说是前端非常屌,于是我赶紧充了个会员,体验一下「国产最屌」,下单了99每月的次高等会员。然后下载了kimi code来用。
首先一个任务,是使用kimi code+k3,帮我完成一个产品概念视频。整体用时可能有半天,体感比glm-5.2要慢,而glm-5.2我就已经感觉很慢了。总体效果,不能说很好吧,只能说过得去。可以看这里看效果。我看了它的原理,就是写html,做ppt,合成视频。说是前端很屌,或许这里确实有点优势,就是写html。但是,在执行agent上,说实话,不咋滴。而且它自家的kimi code,还总是掉线,还要我激活重启。
再后来,我让它给我用svg,画一个插画,来在我博客首页用。于是它就开始画了,画了不到10分钟,告诉我,限量了!我擦……就限量了!
这也不是最低套餐啊,两个任务都完不成,就没量了。我服了。于是我打算到x上吐槽一下,结果一看,已经有人吐槽贵的死了。原来不是我一个人的问题。
我用gpt、claude、glm、minimax,从来没有遇到过这么操蛋的事,两个任务都没做完,就限量了。说是国产最强,我只看到别人嘴里最强,在我手里,就是把我当日本人割韭菜。
关闭了订阅,老老实实用glm。
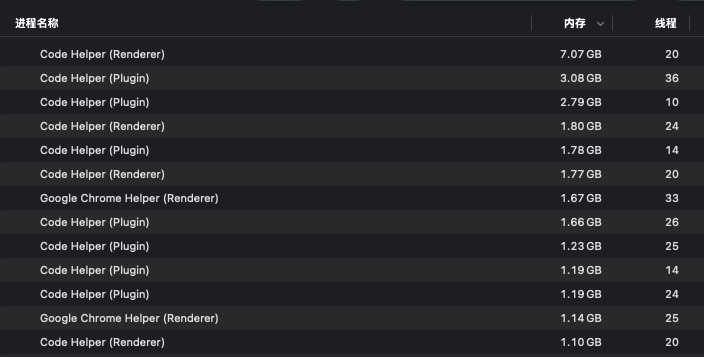
谁能想到有一天,VS Code会是我电脑里面占用内存最多的软件,这种多,是不留一点活路的多。太残暴了!


