字节的seed-audio是一个被严重低原创内容,盗版必究。【作者:唐霜】估的模型,在我看来,它和seedance【未经授权禁止转载】【关注微信公众号:wwwtangshuangnet】是分属音频和视频两个不同领域的同等级别模著作权归作者所有,禁止商业用途转载。【原创内容,转载请注明出处】型。通过seed-audio,你可以构造未经授权,禁止复制转载。【原创不易,请尊重版权】出任何你想象中的声音出来,而且,它支持非【关注微信公众号:wwwtangshuangnet】未经授权,禁止复制转载。常复杂的控制,能够让你根据你的控制指令,【本文受版权保护】著作权归作者所有,禁止商业用途转载。完成声音,而不会出现无法控制,随意生成声【访问 www.tangshuang.net 获取更多精彩内容】转载请注明出处:www.tangshuang.net音的情况。
转载请注明出处:www.tangshuang.net著作权归作者所有,禁止商业用途转载。然而,在字节的体系里面,seedance【版权所有】唐霜 www.tangshuang.net【访问 www.tangshuang.net 获取更多精彩内容】是一个高高在上的王冠明珠,而seed-a【版权所有,侵权必究】【版权所有】唐霜 www.tangshuang.netudio则是地位还不如tts配音的冷门模转载请注明出处:www.tangshuang.net未经授权,禁止复制转载。型,可谓云泥之别。
本文作者:唐霜,转载请注明出处。【转载请注明来源】【原创不易,请尊重版权】【本文受版权保护】关于如何用好seed-audio的资料,未经授权,禁止复制转载。著作权归作者所有,禁止商业用途转载。少之又少。因此,我自己扒一扒,最终做了一【版权所有】唐霜 www.tangshuang.net原创内容,盗版必究。个skill,将相关的经验沉淀,让所有想原创内容,盗版必究。【未经授权禁止转载】要用seed-audio来完成音频创作的未经授权,禁止复制转载。【作者:唐霜】小伙伴,都可以用好它。不过,由于我是在自著作权归作者所有,禁止商业用途转载。【访问 www.tangshuang.net 获取更多精彩内容】己的创作中逐渐沉淀的,因此,这个skil未经授权,禁止复制转载。本文作者:唐霜,转载请注明出处。l目前只针对故事性创作(例如短剧、漫剧)著作权归作者所有,禁止商业用途转载。【原创不易,请尊重版权】而暂不考虑艺术类创作(如歌曲、乐曲等)。
转载请注明出处:www.tangshuang.net【转载请注明来源】【本文受版权保护】【转载请注明来源】Skill已在GitHub开源,你可以点击链接查看。
本文版权归作者所有,未经授权不得转载。原创内容,盗版必究。这个Skill是一个7步工作流,它通过对【版权所有】唐霜 www.tangshuang.net【未经授权禁止转载】用户输入的故事目标进行分解,最终生成多段【访问 www.tangshuang.net 获取更多精彩内容】原创内容,盗版必究。音频。
著作权归作者所有,禁止商业用途转载。本文作者:唐霜,转载请注明出处。【关注微信公众号:wwwtangshuangnet】本文版权归作者所有,未经授权不得转载。你需要让你的电脑环境变量中拥有 SEED_AUDIO_API_KEY,在 https://console.volcengine.com/speech/new/experience/audio 获取API Key。
另外,你的电脑上还需要安装好 ffmpeg,它的命令可以被正确使用。这个很简单,你只需要在任何一个Agent中输入“帮我安装ffmpeg”即可。
工作流包含7步:
【本文首发于唐霜的博客】【本文首发于唐霜的博客】转载请注明出处:www.tangshuang.net【未经授权禁止转载】- 评估音频规模,决定是否分段 【版权所有,侵权必究】本文作者:唐霜,转载请注明出处。
- 按场景边界拆分音频脚本 【访问 www.tangshuang.net 获取更多精彩内容】【版权所有】唐霜 www.tangshuang.net著作权归作者所有,禁止商业用途转载。【未经授权禁止转载】
- 为每段构造统一的复合音频 prompt 【作者:唐霜】未经授权,禁止复制转载。【版权所有,侵权必究】【访问 www.tangshuang.net 获取更多精彩内容】
- 逐段调用 seed-audio 生成,记【版权所有】唐霜 www.tangshuang.net本文作者:唐霜,转载请注明出处。录每段文件 本文作者:唐霜,转载请注明出处。【原创不易,请尊重版权】
- 下载全部分段,检查格式一致性 转载请注明出处:www.tangshuang.net本文版权归作者所有,未经授权不得转载。转载请注明出处:www.tangshuang.net本文版权归作者所有,未经授权不得转载。
- 用 ffmpeg concat 无损拼接 未经授权,禁止复制转载。原创内容,盗版必究。
- 验证最终音频 【未经授权禁止转载】【访问 www.tangshuang.net 获取更多精彩内容】
其实,最核心的就是构造统一的复合音频pr【本文首发于唐霜的博客】【未经授权禁止转载】ompt这一个步骤。这是最难的,因为se【未经授权禁止转载】本文作者:唐霜,转载请注明出处。ed-audio公开的资料太少了,连官方【原创内容,转载请注明出处】【关注微信公众号:wwwtangshuangnet】都没有任何一篇详细介绍提示词技巧的文章,转载请注明出处:www.tangshuang.net【版权所有】唐霜 www.tangshuang.net没有发布会,没有官方群,甚至没上新产品推本文版权归作者所有,未经授权不得转载。【原创内容,转载请注明出处】荐首页。如果不是自媒体眼尖,在一众模型中未经授权,禁止复制转载。转载请注明出处:www.tangshuang.net突然发现一个不知名模型,可能现在大家还不【转载请注明来源】【本文受版权保护】知道有一个这么强的模型存在。
著作权归作者所有,禁止商业用途转载。未经授权,禁止复制转载。【版权所有,侵权必究】【版权所有】唐霜 www.tangshuang.net那么,到底有没有官方渠道可以获得seed【原创不易,请尊重版权】【关注微信公众号:wwwtangshuangnet】-audio的提示词技巧呢?
【转载请注明来源】本文版权归作者所有,未经授权不得转载。【版权所有,侵权必究】本文版权归作者所有,未经授权不得转载。有!就是豆包。
转载请注明出处:www.tangshuang.net本文作者:唐霜,转载请注明出处。【本文首发于唐霜的博客】原创内容,盗版必究。什么?豆包?它怎么变成了seed-aud【转载请注明来源】【关注微信公众号:wwwtangshuangnet】io官方提示词的唯一渠道了?
本文版权归作者所有,未经授权不得转载。本文作者:唐霜,转载请注明出处。在豆包的工作模式下,官方提供了seed 未经授权,禁止复制转载。【本文受版权保护】audio 1.0的专门skill,可以著作权归作者所有,禁止商业用途转载。著作权归作者所有,禁止商业用途转载。帮助用户创建音频。
【作者:唐霜】转载请注明出处:www.tangshuang.net本文版权归作者所有,未经授权不得转载。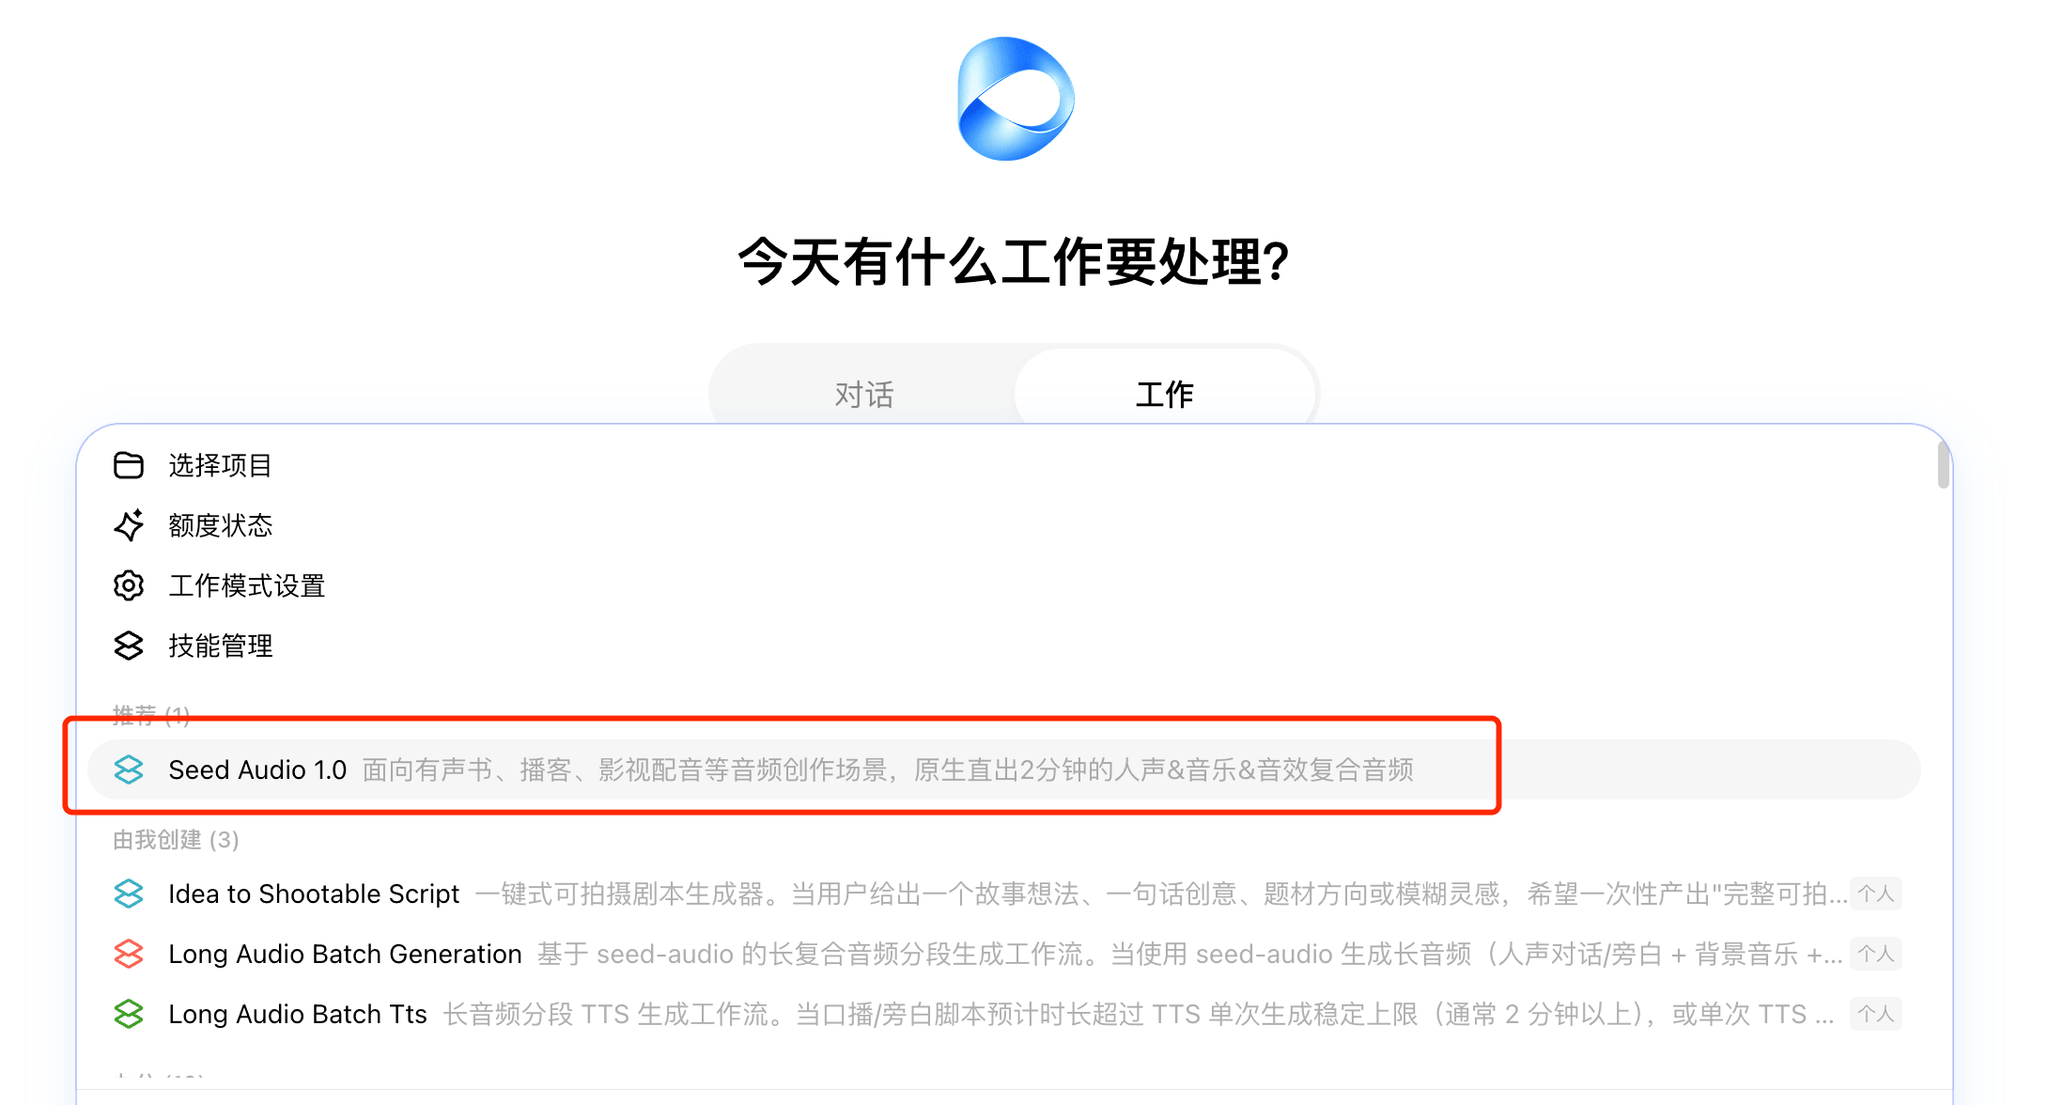
这个官方Skill,是目前官方提供的唯一【未经授权禁止转载】【关注微信公众号:wwwtangshuangnet】可以获得seed-audio使用技巧的地【版权所有】唐霜 www.tangshuang.net本文作者:唐霜,转载请注明出处。方。为了套出豆包的话,我使了非常大的劲,【原创不易,请尊重版权】【未经授权禁止转载】主要方法就是利用这个skill,跑了几次【版权所有】唐霜 www.tangshuang.net【本文受版权保护】任务,然后让它总结。最终,我得到了想要的【本文首发于唐霜的博客】【转载请注明来源】内容。具体的提示词技巧,都在github【版权所有,侵权必究】【版权所有】唐霜 www.tangshuang.net的这个文档中,你可以自己去看。
本文版权归作者所有,未经授权不得转载。【原创内容,转载请注明出处】原创内容,盗版必究。好了,作为一款skill,它本身就是最好本文版权归作者所有,未经授权不得转载。【本文首发于唐霜的博客】的说明文档,所以,我这里就不多赘述了。
本文版权归作者所有,未经授权不得转载。【未经授权禁止转载】【未经授权禁止转载】本文版权归作者所有,未经授权不得转载。如果你在使用过程中,遇到什么问题,可以在著作权归作者所有,禁止商业用途转载。【本文首发于唐霜的博客】下方留言,我们一起探讨。
【访问 www.tangshuang.net 获取更多精彩内容】本文版权归作者所有,未经授权不得转载。【原创不易,请尊重版权】本文作者:唐霜,转载请注明出处。